2026/10/8
使用代理式 AI 将 CUDA Tile 操作从 Python 转换为 Rust
cuTile Rust (cutile-rs) 是一个基于图块的系统,用于使用 Rust 编程语言进行安全的惯用 GPU 内核创作。它将 Rust 所有权模型扩展到基于平铺的 GPU 内核,将可变输出分割为不相交的部分,并在内核启动期间保留主机端所有权合同。它还允许编程人员在需要较低级别的控制时在本地选择退出,从而直接执行平铺 IR 运算。
TileGym CUDA tile 内核库积累了一个使用 CUDA Tile Python (cuTile Python) 和 Triton-TileIR (nvtriton) 编写的大型生产级内核库。为了在 Rust 中提供所有这些内核,我们的团队构建了一种 AI 智能体技能,将 cuTile Python 和 Triton-TileIR 内核转换为 cuTile Rust。
借助这项技能,我们将所有 24 个公开的 TileGym 运算符移植到 cuTile Rust,并使 cuTile Python 的平均性能达到 99.5%。它们总共包含大约 40 个 GPU 内核,涵盖从元素级运算到闪光注意力解码、多头潜在注意力 (MLA) 和混合专家 (MoE) 模型。请注意,一些运算符需要多个内核变体。
每次转换都从 Operator 拥有的任何参考实现 ( cuTile Python 或 Triton-TileIR) 开始,并通过涵盖分析、设备内核、主机和 FFI 代码以及基准测试的边界多代理工作流运行。每个阶段都以机器可检查的结果结束,由验证器脚本和平铺 IR 差异决定转换是否向前推进。主要挑战在于,cuTile Python JIT 编译在调用时以隐式方式专门化每个内核,而 Rust 则要求您在内核签名中声明每个专门化。
本文将介绍我们如何开发多智能体工作流,将 cuTile Python 和 Triton-TileIR 内核转换为 cuTile Rust,并在每个阶段检查正确性和性能。它涵盖了真实内核中的差距、如何构建技能以避免在信任的基础上进入任何阶段,以及生成的内核如何根据其引用执行操作。这些技能在 TileGym 库中发布,因此您可以将其应用到自己的内核中。
Tile IR 前端之间的内核转换
cuTile Python、Triton-TileIR 和 cuTile Rust 是同一 IR 上的三个前端:CUDA Tile IR。这三者都输入相同的 tileiras 编译器,该编译器执行图块级优化并发出 GPU 二进制文件。这一共享基础使得跨 CUDA Tile 系列的转换变得切实可行,并且同样重要的是,可验证。
cuTile Python ─┐ Triton-TileIR ─┼─► CUDA Tile IR (cuda_tile dialect) ─► tileiras ─► cubin cuTile Rust ─┘
TileGym 生产版 Tile 内核是针对前两个前端编写的。由于这三者都在同一 IR 下相遇,因此将核函数移植到 cuTile Rust 并不是重新优化的问题。它使用更安全的主机语言重新表达相同的图块程序,下面使用相同的编译器和相同的性能模型。共享的 IR 使翻译可被检查。
忠实端口应再现参考内核的 IR 结构:相同的内存操作系列、相同的图块形状和相同的归约。由于所有三个前端都发出相同的 tileiras 编译器,因此可以通过转储参考内核 Tile IR 和转换后的内核 Tile IR,并在执行单个测试之前“比较”它们来直接验证这一点。
这不仅能在功能上检查智能体的输出,还能在结构上检查智能体的输出。错误但可信的转换 (例如,带有错误成本提示的 TMA 负载或已删除的可分割属性) 可能会通过测试,但在测试范围之外仍不正确,并可能导致性能回归。通过与参考 IR 进行比较,可以轻松地检查和修复这些问题。IR 差异阶段是本文所述工作流的核心。
在本次讨论中,Rust 前端的另外两个方面也需要注意。首先,提前编译 Rust 源代码。rustc 会检查图块形状和元素类型。crate 嵌入内核 AST,并在首次启动时使用具体的 const-generic 值对其进行专门化,然后编译 cubin (之后进行缓存) 。GPU 二进制文件本身仍然是 JIT 编译的,但隐性消失了:除非内核签名声明,否则什么都不会专门化。其次,在 TileGym 中,cuTile Rust 只是另一个后端。tilegym.set_backend("cutile-rs") 将相同的 Operator API 路由到 Rust 内核。
明确专门化
这两个前端在专门化的位置上有所不同。cuTile Python JIT 专注于它在调用时看到的任何内容。cuTile Rust 仅专注于内核签名声明的内容。大多数翻译工作都是通过拼写 Python 源代码中隐含的内容来完成的。下表总结了主要案例。
| cuTile Python (隐式 JIT) | cuTile Rust ( AOT Rust 源代码) | 翻译结果 |
|---|---|---|
如果在编译前丢弃 ct.Constant 分支,则不予采用 | 两个分支都必须进行类型检查 | 一个 Python 内核会变成多个结构化 Rust 条目 (例如,由于分支会更改图块排名,layer_norm 会拆分成 2-D nchw 和 1-D w1 条目) |
任何 dtype 组合均可按需编译 | FFI 通过固定的 symbol/dtype 表进行调度 | 支持 dtype 是显式 ABI 扩展;共享表涵盖 f32/f16/bf16/i32/i64/f8e5m2/f8e4m3fn |
| JIT 类型系统是输入验证 | 过去的 C ABI 并没有安全保障,所以跨出错误的一步就是无声的失败,而不是例外 | 两个防御层:Python 包装器中的语义检查、FFI 后面带有命名返回代码的 ABI 检查 (null/dtype/device) |
表 1. cuTile Python-Rust 翻译差距示例
下一节将使用真实的内核示例说明这些差异。
Softmax 翻译示例
此示例内核有意简单,因此您可以逐行比较这两个版本。首先,在 cuTile Python 中:
@ct.kernel def softmax_kernel(output, input, TILE_SIZE: Constant[int]): row_idx = ct.bid(0) # one CTA per row
row = ct.load(input, index=(row\_idx, 0), shape=(1, TILE\_SIZE), padding\_mode=ct.PaddingMode.NEG\_INF)row = ct.astype(row, ct.float32)row\_max = ct.max(row, axis=1, keepdims=True)numerator = ct.exp(row - row\_max)denominator = ct.sum(numerator, axis=1, keepdims=True)out = numerator / denominatorout = ct.astype(out, input.dtype)ct.store(output, index=(row\_idx, 0), tile=out)cuTile Rust 中的相同内核:
#[cutile::module] pub mod softmax_module { use cutile::core::*;
#\[cutile::entry()\]pub fn softmax\_kernel\<E: ElementType, const TILE\_SIZE: i32>( output: \&mut Tensor\<E, { \[1, TILE\_SIZE\] }>, // one row per CTA input: \&Tensor\<E, { \[-1, -1\] }>,) { let row\_idx = get\_tile\_block\_id().0; // ct.bid(0) // ct.load(..., padding\_mode=NEG\_INF): a safe partition view whose ragged // columns pad with -inf, then a load of this CTA's row. let token: Token = get\_tensor\_token(input); let row\_view: Partition\<E, { \[1, TILE\_SIZE\] }> = make\_partition\_view( input, const\_shape!\[1, TILE\_SIZE\], padding::NegInf, dim\_map::Identity, token); let row: Tile\<E, { \[1, TILE\_SIZE\] }> = row\_view.load(\[row\_idx, 0i32\]); let row: Tile\<f32, { \[1, TILE\_SIZE\] }> = convert\_tile(row); // ct.astype(f32) let row\_max: Tile\<f32, { \[1\] }> = reduce\_max(row, 1i32); let shifted = row - row\_max.reshape(const\_shape!\[1, 1\]) .broadcast(const\_shape!\[1, TILE\_SIZE\]); let numerator: Tile\<f32, { \[1, TILE\_SIZE\] }> = exp(shifted); let denominator: Tile\<f32, { \[1\] }> = reduce\_sum(numerator, 1i32); let out = numerator / denominator.reshape(const\_shape!\[1, 1\]) .broadcast(const\_shape!\[1, TILE\_SIZE\]); let out: Tile\<E, { \[1, TILE\_SIZE\] }> = convert\_tile(out); // ct.astype(dtype) output.store(out); // ct.store}}
您可以直接阅读对应内容。之所以如此简洁,是因为两端都是相同 Tile IR 运算上的薄薄表面:
Constant[int]参数变为 const 泛型 (const TILE_SIZE: i32) ,并由主机通过相同的 Tile IR JIT 按启动形状进行实例化。ct.load(..., padding_mode=NEG_INF)变成了两个明确的步骤。首先构建一个make_partition_view(..., padding::NegInf, ...),然后构建一个Partition::load,与参考 IR 包含的 TMA 支持的视图加载相同,并将破损的尾部填充到-inf。ct.bid(0)映射到get_tile_block_id()。- cuTile Python 保留的隐式内容成为显式类型。每个中间值都是一个
Tile<f32, {[1, TILE_SIZE]}>,一个keepdims=True归约为一个reduce_*,然后是一个显式reshape和broadcast。
然后,IR 差异会确认 Rust 编译到与 Python 原始版本相同的操作清单:一个视图加载,reduce_max/reduce_sum 位于右侧轴,一个视图存储,TMA 位于两端。请注意,TileGym 中并非所有已发布的内核都使用这种完全安全的方式。每个端口都必须精确再现参考内核 Tile IR,因此如果只有未勾选的 API 再现了该参考内核 Tile IR,则端口会使用该 API。我们仍在将这些内核迁移到本文中所示的安全表面。
跨越 C ABI
示例 kernel.rs 已经是一个完整、一流的 cuTile Rust 内核。Rust 应用可以依赖 cutile crate,包含内核模块,并直接通过 crate 类型的 API (所有权检查、图块类型等) 启动其条目,且不涉及 FFI。
C-ABI 层的用途更窄:将这些内核插入 TileGym Python 调度和测试框架 (以及通过相同的机制,插入任何非 Rust 主机) 。
每个运算符从聚合的 cdylib (整个库一个 libcutile_kernels.so) 中导出一个 C 符号。张量作为简单描述符结构 (ptr, ndim, shape[], strides[]) 在 Rust 和 Python 之间进行交叉映射:
#[unsafe(no_mangle)] pub unsafe extern "C" fn cutile_softmax( out: *const TensorDesc, inp: *const TensorDesc, n_rows: i32, tile_size: i32, device_id: i32, raw_stream: u64, ) -> i32 { let out_d = unsafe { &*out }; let inp_d = unsafe { &*inp }; let device = Device::new(device_id as usize).expect("device"); let stream = unsafe { Stream::borrow_raw(raw_stream as *mut c_void, &device) }; let mut y = unsafe { borrow_f32(out_d, device_id as usize) }; let x = unsafe { borrow_f32(inp_d, device_id as usize) }; let y_part = (&mut *y).partition([1, tile_size as usize]); match softmax_kernel(y_part, &*x).sync_on(&stream) { Ok(_) => 0, Err(_) => -1, } }
在 Python 方面,cffi 会将该符号与作为签名单一事实来源的 cdef 字符串绑定。包装器是带有验证检查的薄层:
_FFI_CDEF = """ int32_t cutile_softmax( const TensorDesc* out, const TensorDesc* inp, int32_t n_rows, int32_t tile_size, int32_t device_id, uint64_t raw_stream); """
def softmax(x): x = x.contiguous(); m, n = x.shape y = torch.empty_like(x) rc = lib.cutile_softmax(_desc(y), _desc(x), m, next_pow2(n), x.device.index or 0, torch.cuda.current_stream().cuda_stream) assert rc == 0 return y
请注意,启动程序绝不会复制、分配,也绝不会取得所有权。borrow_f32 将 PyTorch 设备指针包装在 ManuallyDrop<Tensor> 中,因此 Rust 可以将其张量传递给内核,而无需释放其并非拥有的内存,并且内核会在调用程序 CUDA 流上异步启动。从 PyTorch 的角度来看,这类似于任何其他扩展程序。
这在 TileGym 中也是无摩擦的,因为 cuTile Rust 会延迟编译。后端跟踪源的更新情况,因此编辑任何 kernel.rs (或 crate manifest 文件) 会使下一次调用在分发前自动重建共享库,并且在开发 – 测试周期中没有显式的 cargo build。在 Rust 中迭代图块内核与在 Python 中一样简单:更改内核,运行测试,新的二进制文件就绪。
智能体技能的工作原理是什么?
NVIDIA/ TileGym GitHub 库中提供的 tilegym-converting-python-to-rust 智能体技能围绕一个设计决策构建:加载它的智能体根本不做任何工程工作。读取 SKILL.md 可将顶层智能体转变为纯编排器,其唯一权限是路由;工作在其衍生的专用子智能体中进行,每个子智能体仅加载其阶段所需的参考文档。我们将介绍每个子代理类型及其在转换中的作用。
分析器解决了“JIT 隐藏规格”问题。在参考核函数中,一旦 DSL 降低到 cuda_tile 语,未被占用的分支消失,并且启动参数位于主机代码中,系统便会烘焙常量。分析器还会选择基准:运算符通常同时具有 cuTile Python 和 Triton-TileIR 实现,因此分析器会对每个执行基准测试,进行比较,然后为每个结构变体选择速度更快的变体,作为端口必须匹配的参考。
在任何 Rust 存在之前,它会为每个变体 (内核编写器的真值) 转储该参考的平铺 IR,并编写 analysis.json,这是一个机器可读规格,包含变体、常量、dtypes、容差、启动网格、自动调优空间和所选基准。所有下游路径均来自此文件。
内核编写器只生成 kernel.rs。主机代码禁止访问,其故障始终是可归因于的。它的难点在于转换差距本身,它被提炼成技能的 49 条编码规则。它两次证明了自己的工作。首先,在功能上,进行 in-Rust 工作流测试,该测试在无 FFI 和无 Python 的情况下运行内核,因此无法隐藏主机工作流背后的数字漏洞。其次,在结构上,通过清除针对分析器参考转储文件的 IR 自我检查。
主机/ FFI 构建器可从 TileGym ( C-ABI 启动器和 Python 包装器) 调用经过验证的核函数,并拥有正确性检查、在所有 dtypes 和 shape 中运行运算符的真实 TileGym 测试套件,并且只有其 ALL_PASS 判断才能解锁基准测试。这是完整堆栈 (内核、启动程序和包装器) 端到端运行的第一个点。
性能验证器运行 CUPTI 基准测试协议 (设备与时间测量,针对同一 GPU 上的参考进行的每配置配对) ,并要求几何平均值在 5% 的范围内着陆。它的工作不是优化,而是诚实地衡量。
两名专家仅在失败时加入。两者都不会编辑代码;两者都通过读取 IR 进行诊断。当正确性测试失败或基准测试失效时,会生成 IR 差异分析器。它按变体将参考图块 IR 与生成的 IR 变体进行比较,并对每个差异进行分类。至关重要的是,这能将误译 (通过特定修复程序路由回核函数编写器) 与任何核函数更改都无法修复的上游编译器错误区分开来。
残差性能调查器获取正确的内核,该内核在某些输入形状上速度较慢,而根会导致边界两侧出现空隙:设备端 (内存操作系列、代码生成) 和主机端 (启动配置、自动调整和包装器逻辑) 。它会生成核函数编写者所操作的报告。
推动这种设计的两个主要原因。首先,完整的转换需要数百万个token。其次,分割隔离了责任。由于核函数在任何主机代码存在之前就已经过独立验证,因此后续发生故障时,其所有者便易于处理。
三种选择可实现这种分割。子智能体仅通过固定模式的伪影进行通信,而从未通过对话进行通信。每个阶段都以机器可检查的结果结束,而编排者无需阅读散文。共享的 cuda_tile 语使 IR diff 成为验证的支柱,既可用作运行测试前的核函数编写者的自我检查,也可用作 IR-diff 分析师在某些操作失败时的深度比较,从而拒绝原本可能通过的结构错误转换 (错误轴的归约、丢失的掩码) 。
编排器循环
转换运行是一台小型状态机,并且编排器自己的指令适合精简的 SKILL.md。步骤详情如图 1 及以下所示。
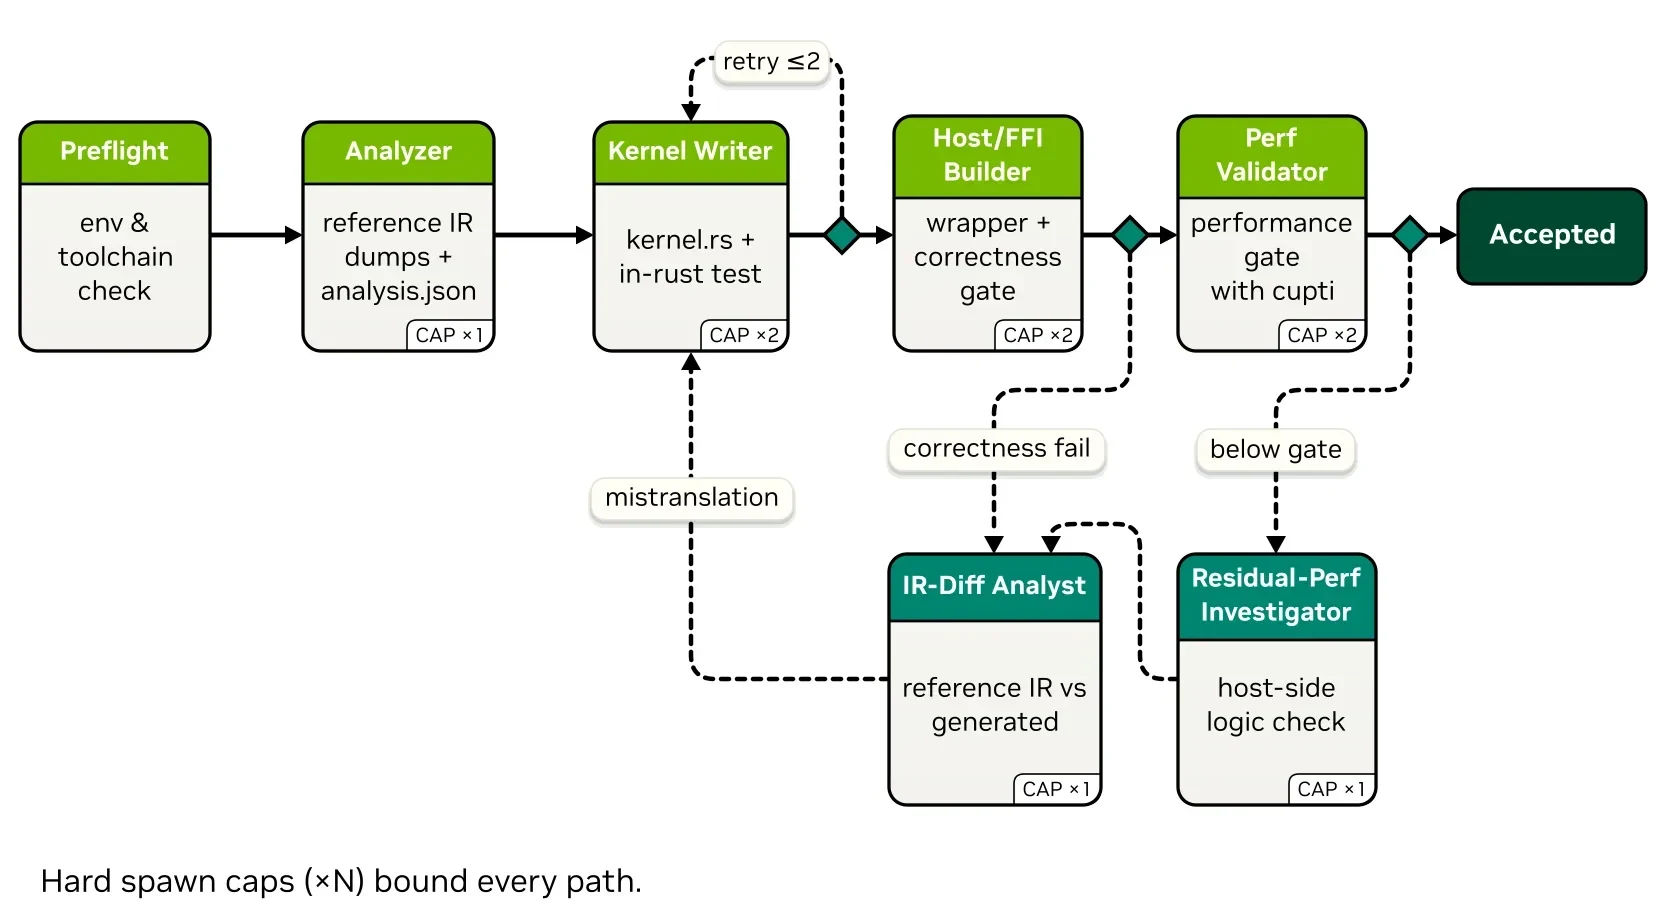
图 1. 转换管道涉及具有边界重试的判断驱动路由
- 预加载:
scripts/preflight.sh验证env变量和工具链路径。非零退出会停止运行:环境不可用,而且没有任何代理努力来修复缺失的编译器。 - 使用最少指针生成:每个子代理都衍生自一个模板,其提示仅包含两个元素:阶段 Step-0 文件列表 (其自身的指令文件加上阶段所需的参考文档) 和上阶段构件的具体路径。编排器绝不会将指令粘贴到提示词中。每个子代理都会读取自己的文件,因此每个阶段的上下文仅包含该阶段所需的内容。
- 机械验证器:每个子代理返回必须以实际的
`<VALIDATOR_OUTPUT>`块和一行`VERDICT:`行结束。编排器检查方块内的退出代码,然后纯粹根据判词进行路线编排;它绝不会从散文中推断出修正。形式错误的回报会获得完全相同的代理修复重生,而永远不会升级。 - 路线逐表:图 1 是整个决策函数。判决推进了绿色路径,故障路径带有机器可读所有者标签 (
host= 构建器自行重生;kernel= IR-diff 分析师分配所有者;env= stop) ,故障性能基准测试路径通过残差性能调查者执行一次。缺少所有者标签本身就是失败。编排器停止而不是猜测,因为错误路由到内核阶段的主机故障会浪费整个重试。 - 硬生成上限:图 1 每个框中的 xN 限制了尝试 (一次分析、两次内核编写器尝试、两次主机构建器尝试、一次诊断、两次基准测试运行和一次可选的性能测试通过) 。运行要么在预算范围内收,要么随着磁盘上的诊断而停止;它不能引起抖动。
- 最终聚合:只有在路由完成后,
validate_kernel.sh才会在所有阶段重新检查完整的 17 文件输出合同:报告、IR 转储、正确性和性能日志。
在磁盘上,技能将每个智能体的角色、共享的知识和验证器分别打包在一起,因此每个子智能体只加载所需内容:
skills/tilegym-converting-python-to-rust/ ├── SKILL.md # entry point + orchestration contract ├── agents/*.md # one instruction file per stage ├── references/ │ ├── coding-rules.md # numbered rules (each from a real failure) │ ├── op-mapping.md # ct.* -> cutile-rs API table │ ├── ir-diff-checklist.md # what counts as a critical IR divergence │ ├── pipeline.md # in-Rust pipeline test harness │ └── performance-checklist.md # benchmark protocol ├── concepts/ # tensor-vs-pointer, FFI bridge, transpose ├── scripts/ # diff_ir.sh + validate_*.sh per agent └── examples/{softmax,bmm}/ # two fully worked conversions
编码规则是经过提炼的故障历史记录。每一个都存在,因为早期转换产生了一个编译的核函数,但如果没有它就错了。它们的范围从窄到结构:assume_div_by 仅适用于指针,而从未适用于 Tensor 条目,广播之前必须重构,并且归约轴记帐必须精确到每个图块排名。
线束如何发挥作用
三层可将 Markdown 转换为正在运行的系统:激活、合同和外部驱动。
激活:运行时通过将任务与其描述相匹配 (“将 Triton-TileIR 或 cuTile Python GPU 内核转换、移植或转换为 cuTile Rust”) 来激活技能。在匹配时,顶层代理仅加载 SKILL.md only,这是一个精简文件,可将其转换为编排器。它永远不会读取子代理文件;这些文件加载在子代理本身内部,仅与参考文档一起记录其舞台需求。
合同:层之间的一切都是一个文件或固定格式的字符串。生成提示是最小的指针,阶段输出是带模式的构件,返回是验证器块和判断线。编排器的全部权限是路由,验证器脚本的全部权限是退出代码。循环中的任何内容都不依赖于一个 LLM 来解释另一个 LLM 的散文。正因如此,24 个无人值守的转换才是可重复的,而不是幸运的。
外部驱动:在生产环境中,一名一次性驱动将技能封装在一起,使每次转换都成为一次性批量作业。它会在每个 Operator 分支上创建新的 Checkout,隐藏目标 Operator 的任何预先存在的实现 (因此代理必须转换) ,在与 Operator 终端分离的容器中启动代理,并从外部轮询进度。运行结束时,驱动应用截取的存储库差异并运行接受检查:TileGym 正确性为绿色,证明 cuTile Rust 后端已实际执行,并且与 cuTile Python 基准相比,CUPTI geomean 加速 = 0.95。只有绿色结果自动提交。精简批驱动运行运算符列表,每次最多可进行两次尝试,并推送通过的分支;失败的转换将作为诊断追踪。
基准测试结果
通过平铺式转换 – Python-to – Rust 技能,核函数转换变得更加高效。Token 成本平均下降到一半左右,每个运算符都经过了数字正确性验证,并且每个运算符的 geomean 速度比 cuTile Python 提高了约 0.95。最终性能数据来自 CI 基准测试流程本身:NVIDIA DGX B200 上的 CUPTI 设备时间 (每个后端一个专用 GPU,24 个运算符中 347 个配对配置) 。对于每种配置,我们在四次 CI 运行中都会进行最佳测量。
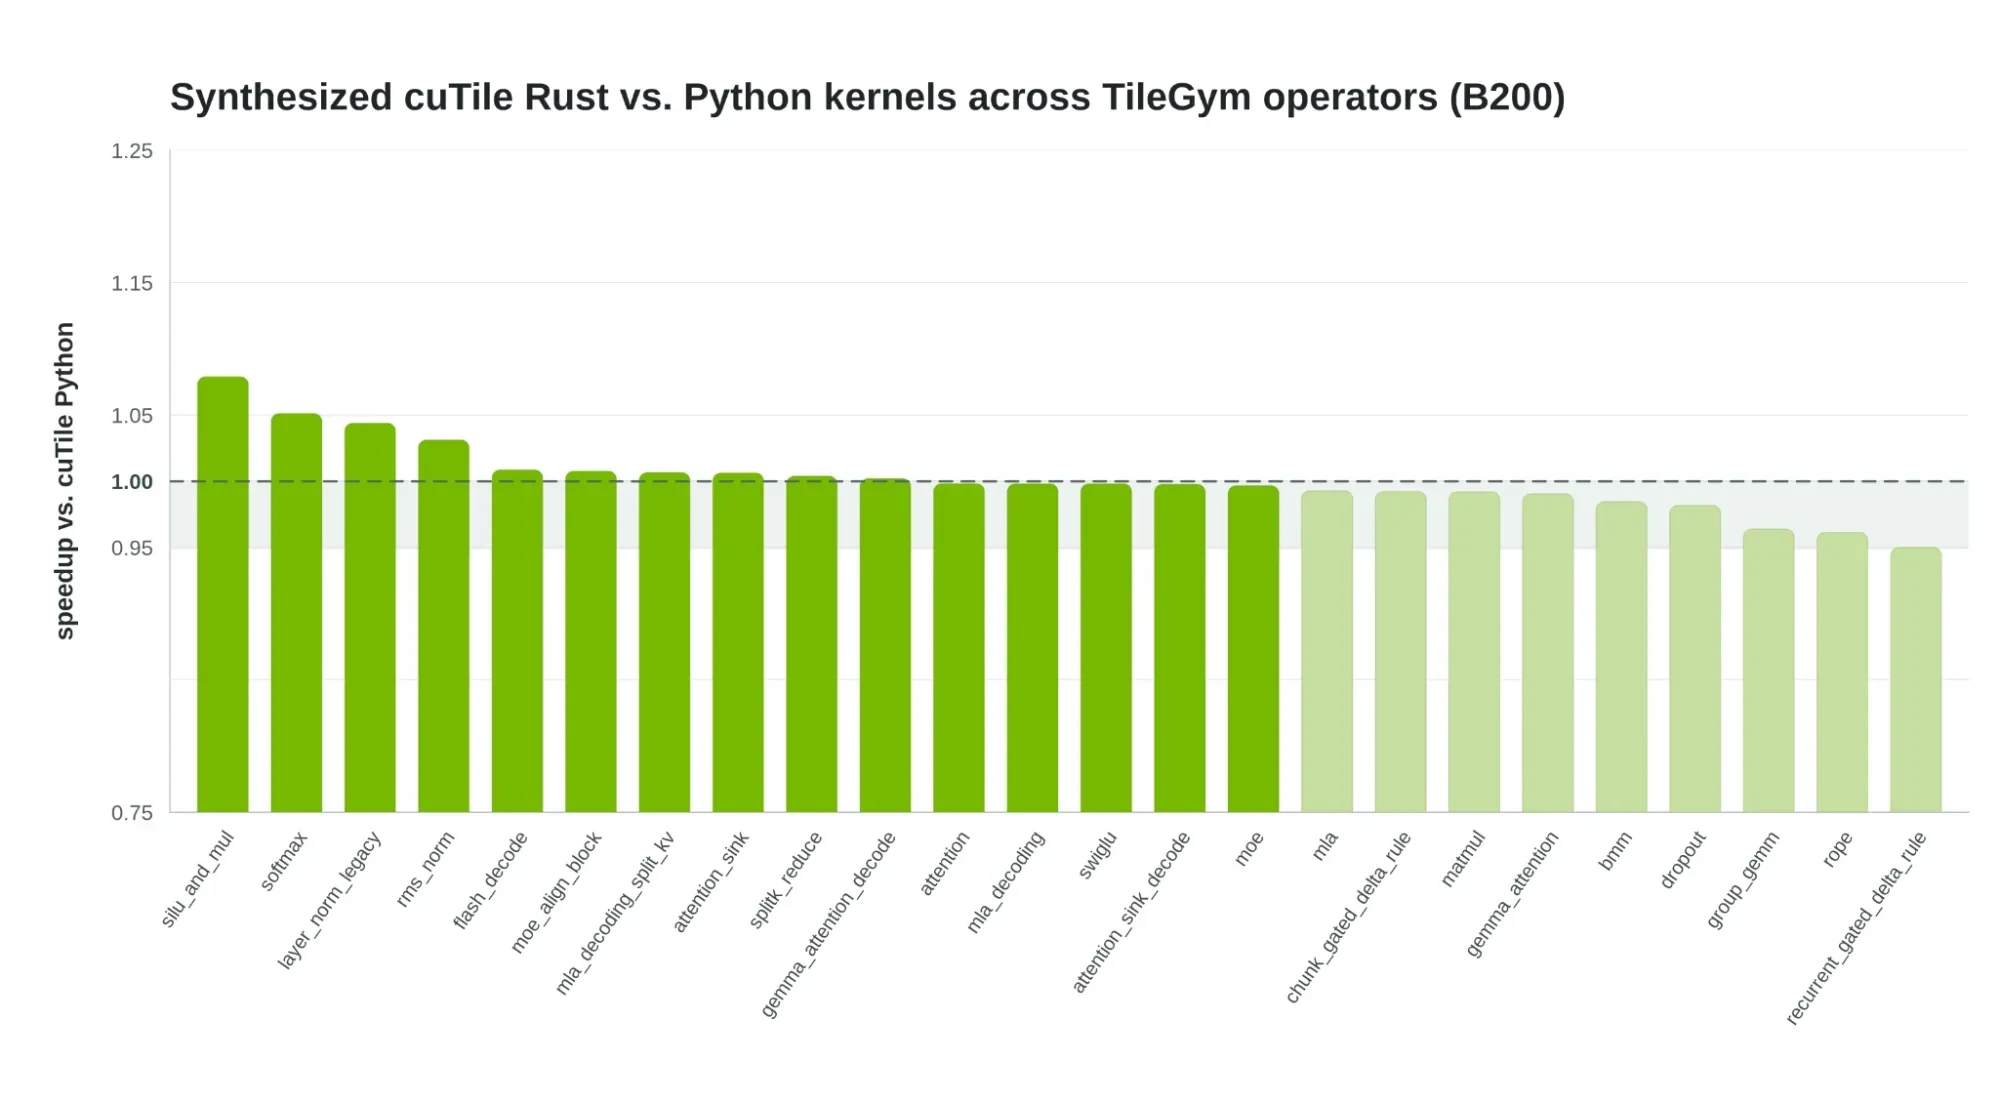
图 2. 在 NVIDIA DGX B200 上的 TileGym 运算符中合成 cuTile Rust 与 cuTile Python
总体 geomean 为 0.995,与 cuTile Python 相同。共享 IR 架构主要解释了这些结果。两个前端都将相同的图块程序馈送到共享优化器中,而忠实翻译通过构建继承了参考的性能。所有 24 个运算符都清除了 0.95 检查,大约三分之一的运算符比参考更早出来,在元素级和归一化内核上获胜次数最大。每次转换都以标准的六文件更改集形式出现,因此审查保持机械性。
图 2 报告 CUPTI 设备时间,用于隔离内核本身。壁钟时间和设备时间可回答有关亚微秒级内核的不同问题。壁钟时间包括启动和调度成本,并反映了用户的体验,而 CUPTI 设备时间则单独比较内核。我们会测量时钟频率并报告设备时间,以便让操作员与操作员对比内核。
cuTile Rust 还可以直接发射 Tile IR。DSL 会将 Tile IR 指令集作为其不安全 API 表面的一部分。原则上,您可以编写一个内核来与其他前端发出的 Tile IR 完全匹配。但是,此类内核变得无法解释,因此该技能偏向于生成惯用代码。由于实验仅捕获设备时间,因此我们期望匹配发射的 Tile IR 将与各前端的性能完全匹配。
开始使用 cuTile Rust 智能体技能
将 cuTile Python 和 Triton-TileIR 内核转换为 cuTile Rust 以及所有转换后的运算符的智能体技能随 TileGym 一起提供。通过技能/ 平铺式转换 – Python-to – Rust/获取技能。它包括每阶段智能体指令、编码规则手册、概念指南、验证器脚本以及已工作的 softmax 和 bmm 示例。通过src/tilegym/ops/cutile_rs/访问内核,包括每个运算符一个 <op>_kernel/ 以及聚合的 cutile_kernels 文件。要求:CUDA 13.1+、用于性能检查的 Blackwell GPU、Rust 1.89+ 和 tileiras 编译器。
首先,将任何代理指向存储库,并要求其“为 <op> 添加一个 cutile-rs 后端”。该工作流负责处理分析、内核、FFI、正确性和基准测试。如需了解更多详情,请参阅 GitHub 上的 TileGym README。
作者声明:转载自 NVIDIA 中文技术博客 · 原文链接
 评论 00
评论加载中…